Issues Tracker Pipeline
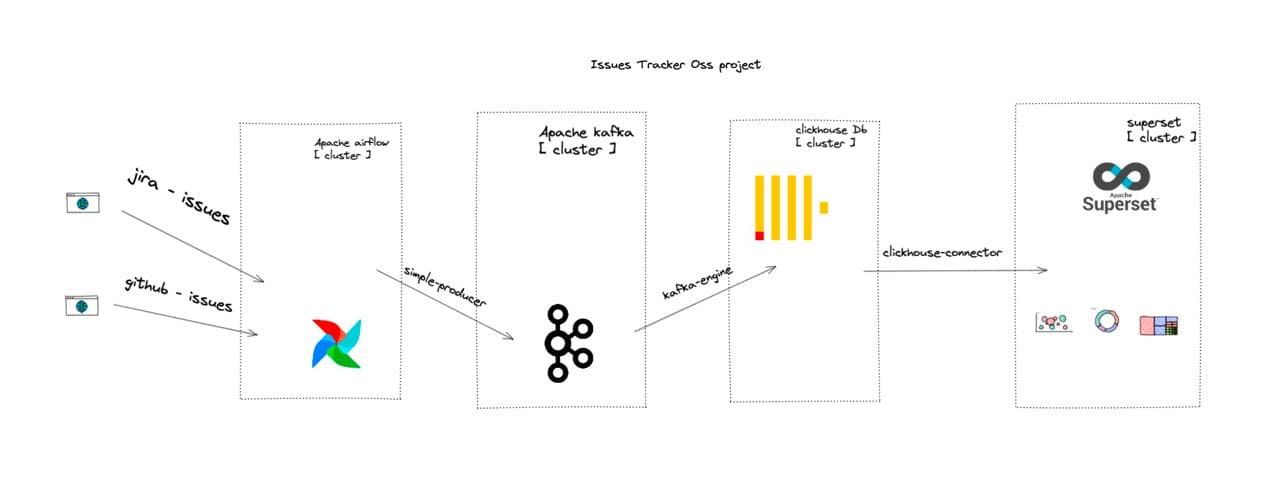
El proyecto extrae issues desde GitHub y Jira, orquesta su procesamiento con Apache Airflow, los publica en Apache Kafka, los almacena en ClickHouse y permite explorar sus métricas mediante Apache Superset.
- Python
- Apache Airflow
- Apache Kafka
- ClickHouse
- Apache Superset
- Docker
- Kubernetes
Galería
Historia del proyecto
El problema
Los equipos y proyectos open source pueden distribuir el seguimiento de incidencias entre plataformas como GitHub y Jira. El reto consistía en recopilar esa información, normalizarla y ofrecer una vista centralizada que permitiera analizar el estado y la evolución de los issues.
La solución
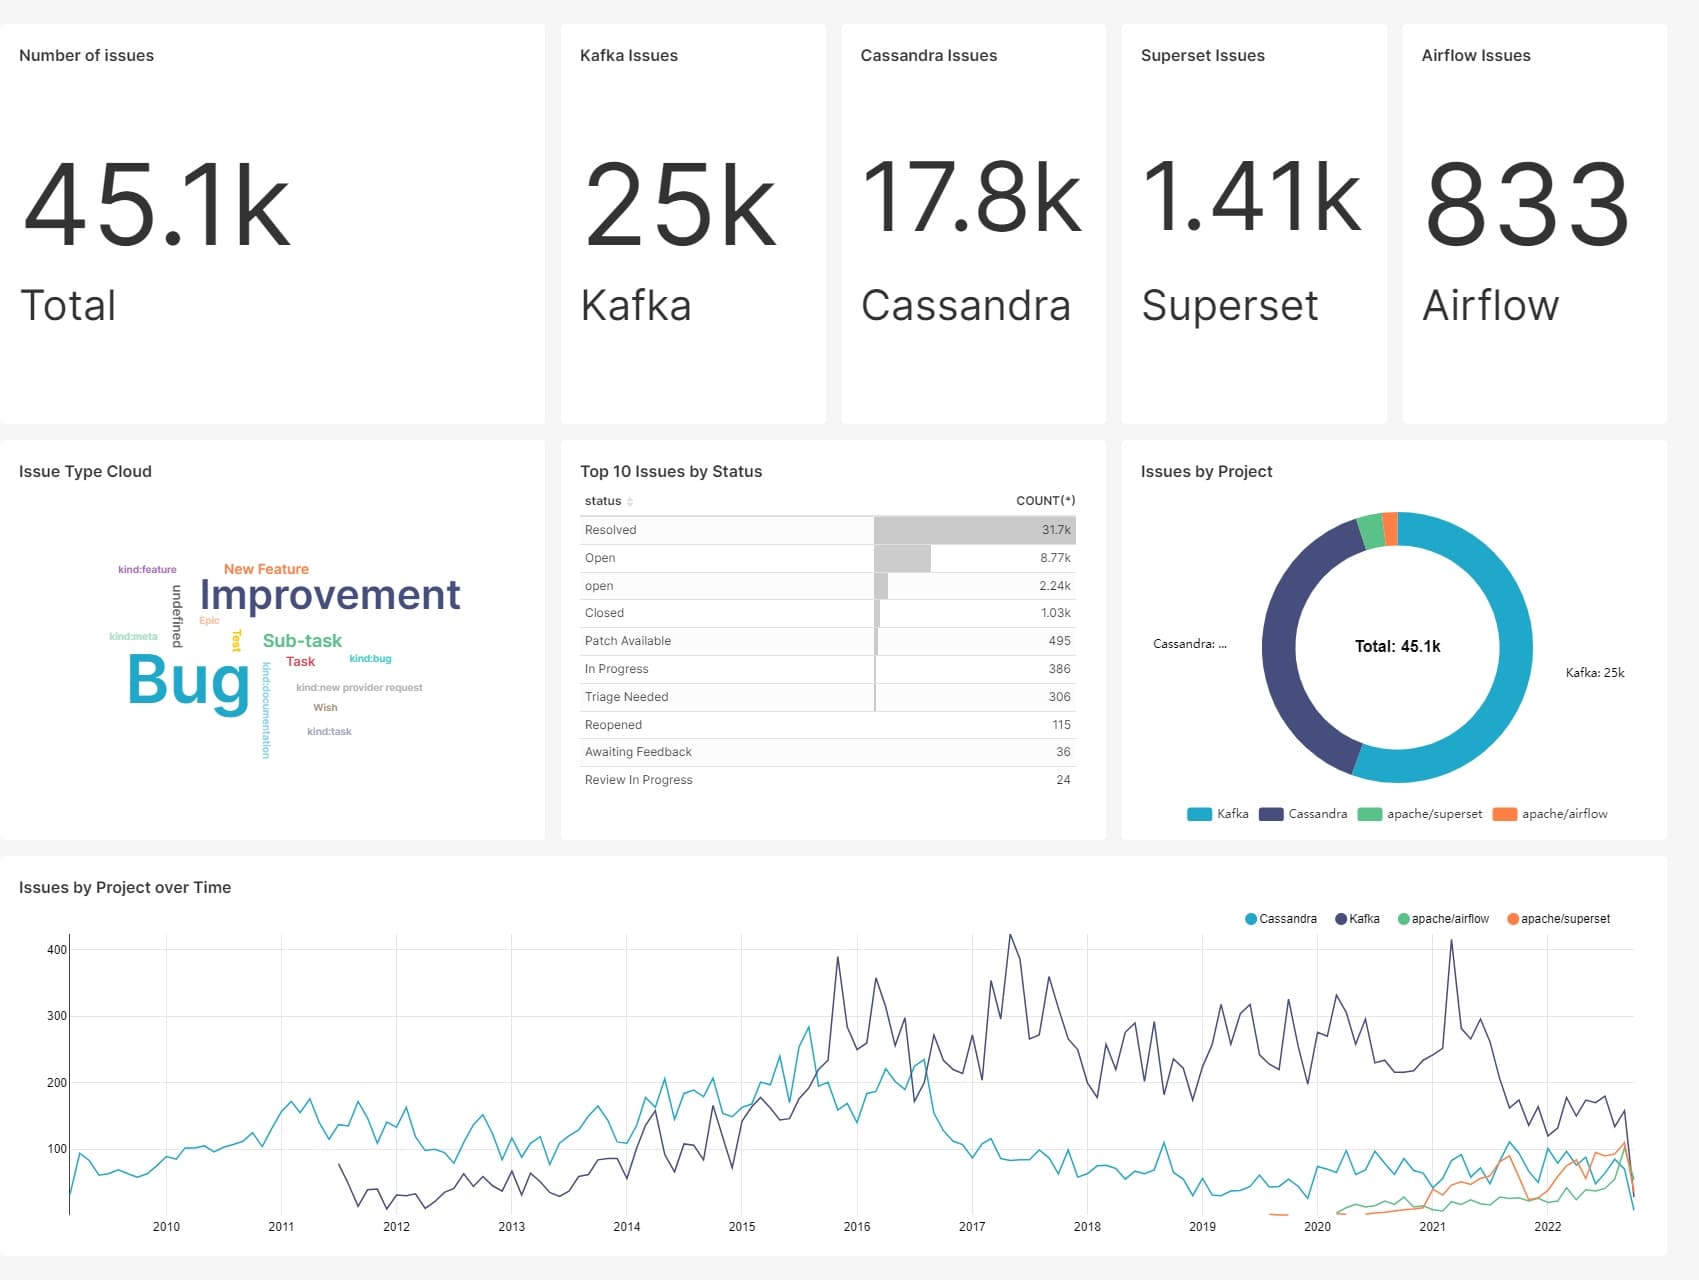
Diseñé un pipeline de datos que extrae los issues desde sus plataformas de origen, orquesta el procesamiento con Apache Airflow sobre Kubernetes y distribuye los eventos mediante Apache Kafka. Los datos procesados se almacenan en ClickHouse y se presentan en dashboards de Apache Superset para facilitar su exploración.
Mi participación
Participé en el diseño e implementación de la arquitectura, la integración entre sus componentes y la creación de un entorno reproducible con contenedores. También preparé y realicé una presentación pública para explicar las decisiones técnicas y demostrar el funcionamiento de la solución.
Aprendizajes
- Diseño de pipelines de datos orientados a eventos.
- Orquestación de procesos con Apache Airflow y Kubernetes.
- Integración de Apache Kafka con ClickHouse.
- Modelado y visualización de información con Apache Superset.
- Comunicación de decisiones técnicas mediante una exposición pública.
Puntos destacados
- Extracción de issues desde GitHub y Jira.
- Procesamiento orquestado con Apache Airflow sobre Kubernetes.
- Ingesta de eventos mediante Apache Kafka.
- Persistencia analítica en ClickHouse.
- Visualización de métricas con Apache Superset.